Jev 是什么?TypeSafe 的 System One 模型实测解析
摘要:Jev 是 TypeSafe AI 于 2026 年 9 月 15 日发布、发布时处于 early access 的 System One 模型,它放弃自由文本生成,只在预先定义的问题空间内返回类型化决策、概率与置信信息。本文核对它的速度、价格与「Zero Hallucinations」宣传,结合第三方实测、社区讨论与独立扑克测评,说明它真正适合哪些 Agent 决策场景,以及哪些结论目前还不能采信。
Tags: Jev, TypeSafe AI, System One, AI 模型, 结构化输出, AI Agent, LLM, 模型评测
01|Jev 发布五天时间线:从一篇博客到开发者社区热议
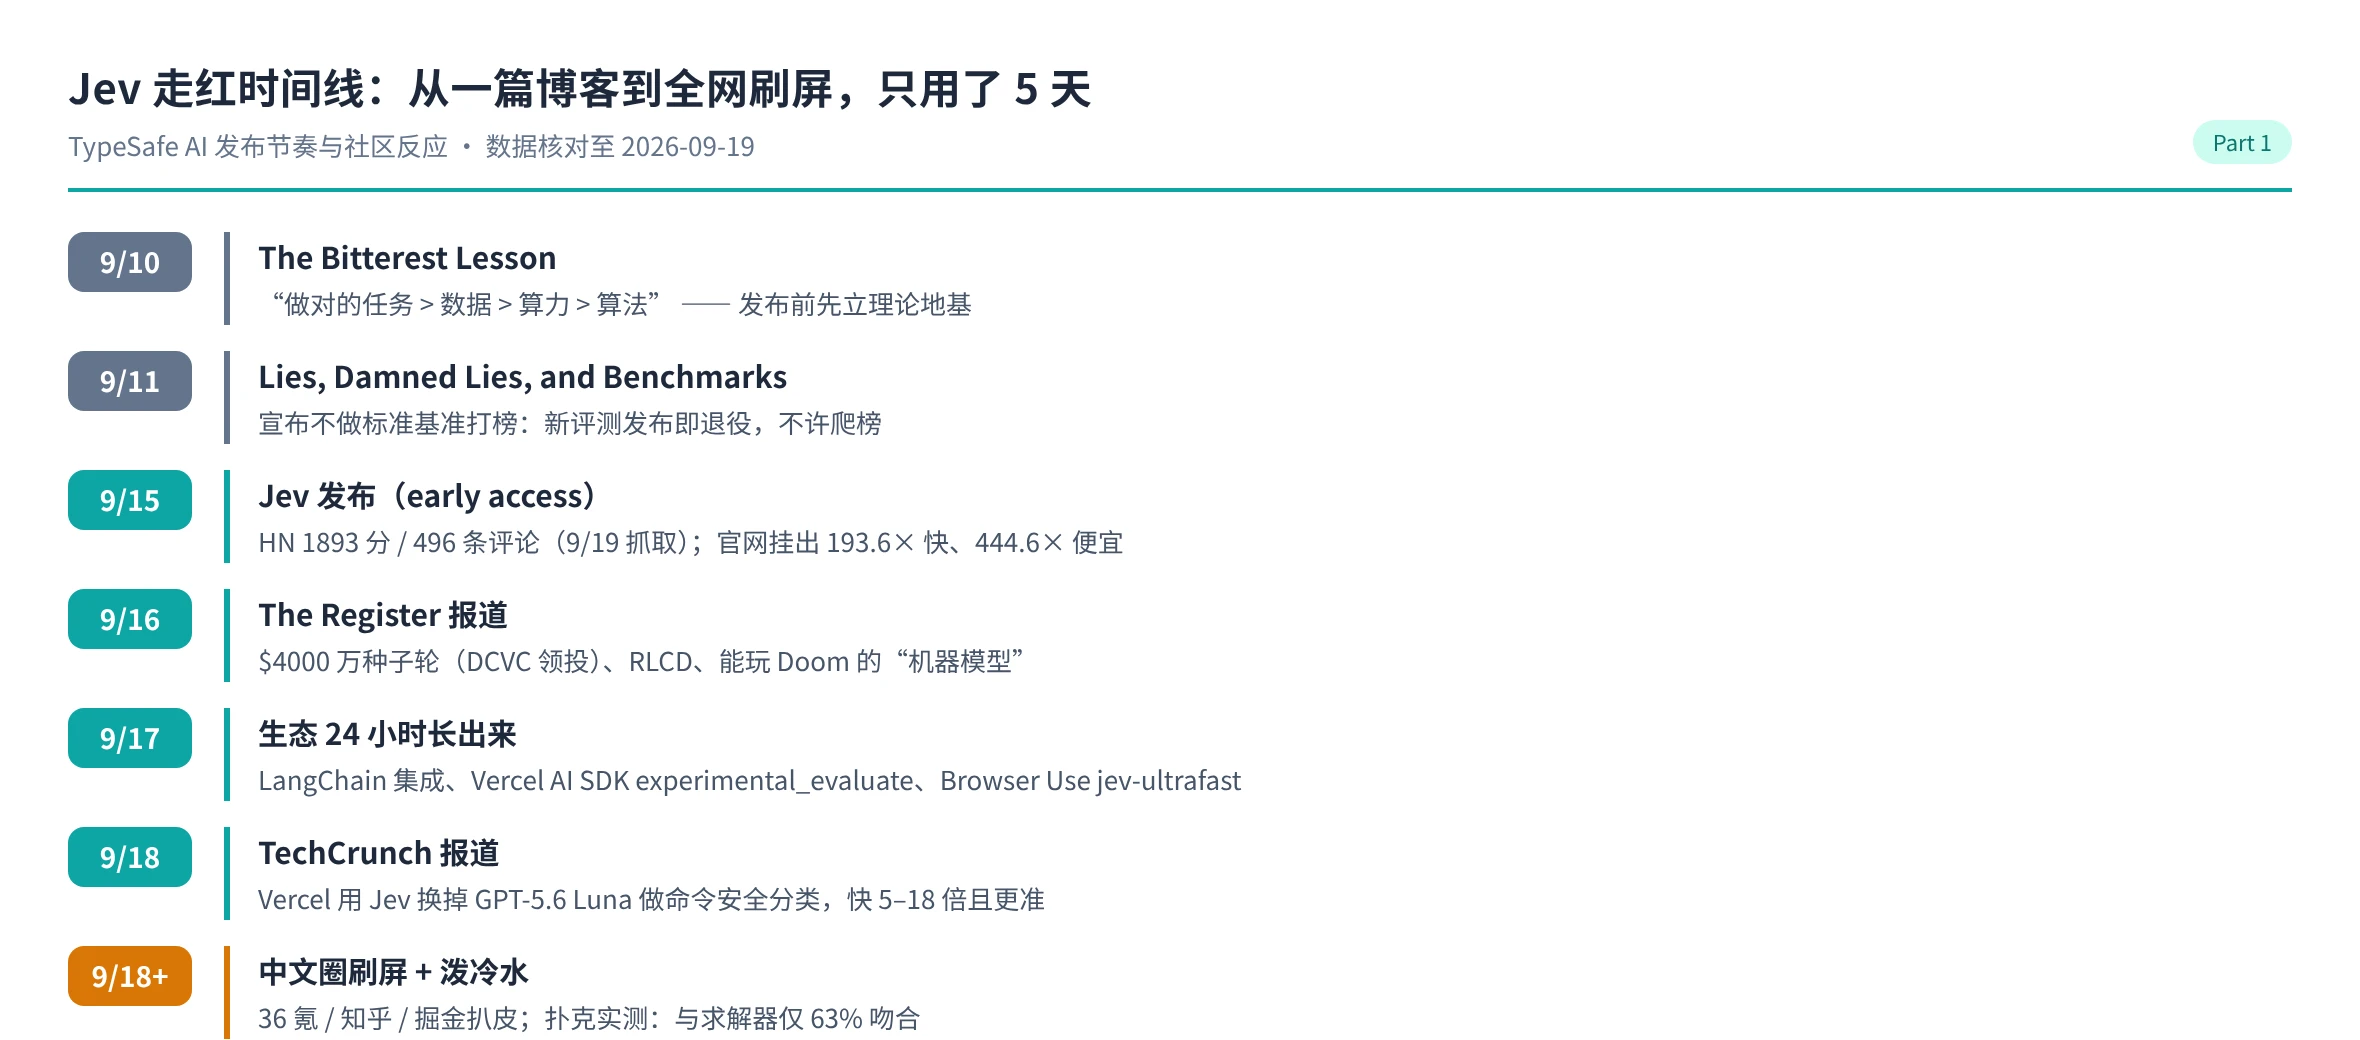
图 1:TypeSafe AI 的发布节奏与社区反应(2026-09-19)。
9 月 15 日,TypeSafe AI 在 Hacker News 发帖介绍新模型 Jev,该帖当天冲上首页,1893 分、496 条评论,并长时间停留在前列。
团队与融资
TypeSafe AI 由 Diogo Almeida、Erik Gafni、Sasha Sheng 于 2024 年创立(官方团队页、投资方 DCVC 的公告)。融资方面:Forbes 报道称公司以 4000 万美元种子轮(DCVC 领投)走出隐身期,引述知情人士称估值 2 亿美元;The Register与 SiliconANGLE 均引用了同一估值口径。注意:估值来自匿名信源,公司未在融资公告中披露正式估值。
Almeida 的履历需要精确表述:他是 InstructGPT 论文的联合作者,也是 RLHF(基于人类反馈的强化学习)相关工作的共同贡献者之一,OpenAI 在 GPT-4 贡献名单中把他列入「Foundational RLHF and InstructGPT work」。他在接受 TechCrunch 采访时解释了自己的动机:
"We have lightning in a bottle, and yet it is not useful."(我们手里握着瓶中的闪电,可它却没什么用。)
理由直白:过去几年行业优化的是人类语言,但真正消费智能的是软件。
两个名字的来源(均为官方 FAQ 原话)
- System One Model:来自丹尼尔·卡尼曼《思考,快与慢》——系统 1 是快而直觉的判断,系统 2 是慢而费力的推理。带思维链的推理模型更像系统 2,Jev 想做系统 1。
- Jev:取自经济学家威廉·斯坦利·杰文斯与杰文斯悖论——效率提升会让资源消耗增加而非减少。TypeSafe 的赌注是:当智能便宜到可以忽略,被塞进软件的次数会指数级增长。
发布之前,官方还先发了两篇铺垫文章:《The Bitterest Lesson》(9/10,主张「做对的任务 > 数据 > 算力 > 算法」)与《Lies, Damned Lies, and Benchmarks》(9/11,宣布不发布标准基准成绩,新评测发布即退役)。这既是姿态,也带来一个直接后果:没有任何公开榜单分数可以外推到你自己的业务。
02|System One 模型到底做了什么:三个原语,一次并行
官方给 System One 模型的定义很克制:
System One 模型是一类供软件直接消费的模型。它读取一个 state,返回类型化的答案与概率。 —— TypeSafe 官方文档
Almeida 的版本更形象:把 Jev 当成一次「前沿智能的函数调用」——输入非结构化状态,输出类型化的概率决策(官方发布公告)。
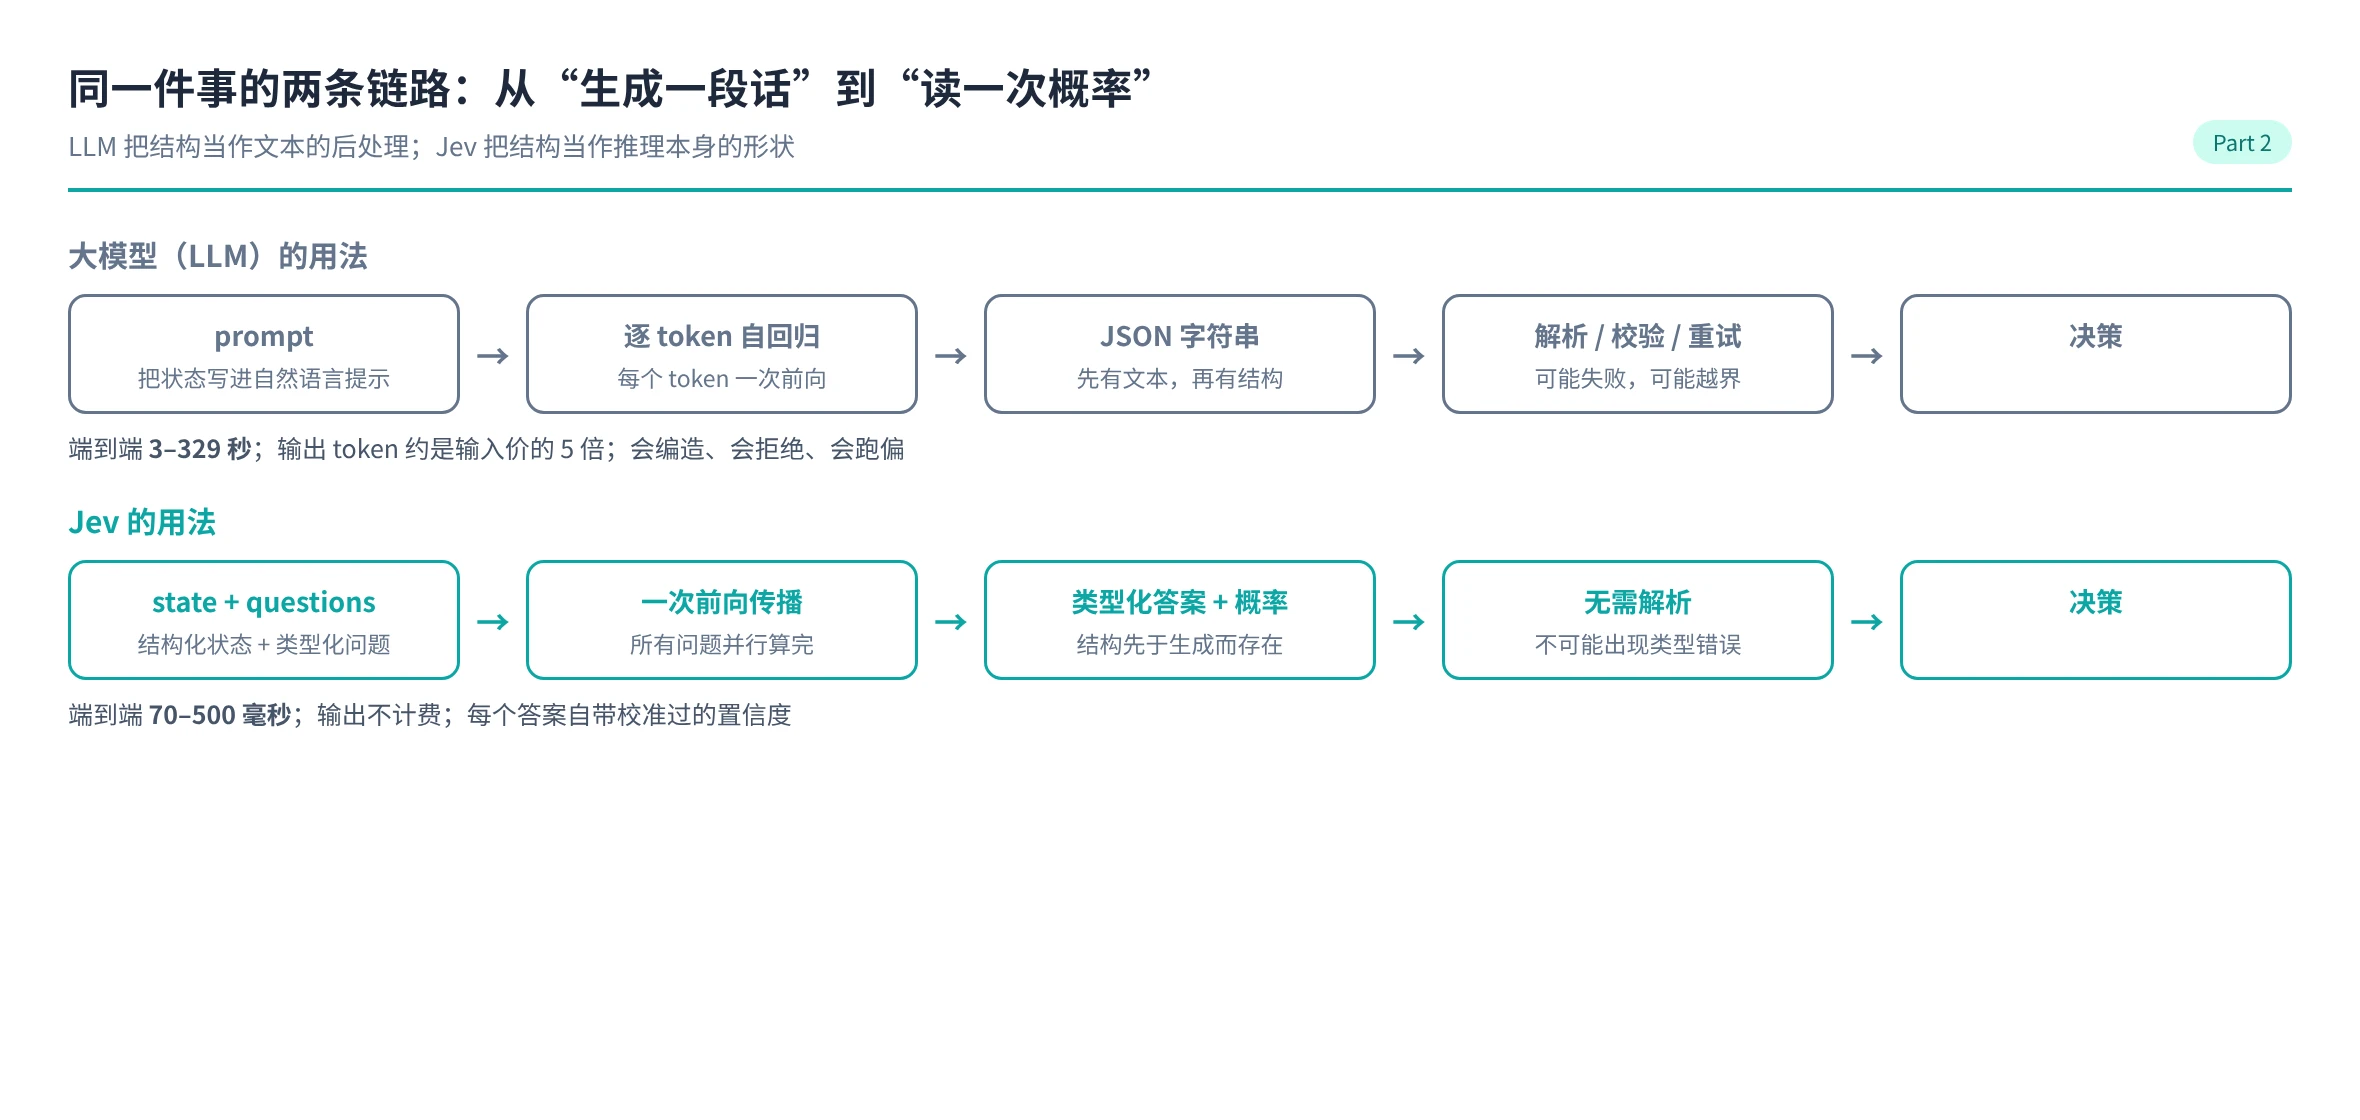
图 2:同一件事的两条链路。LLM 把结构当作文本的后处理;Jev 把结构当作推理本身的形状。
官方对比表(节选)
| 现有 LLM | Jev(System One 模型) | |
|---|---|---|
| 训练优化目标 | RLHF / RLVR:人类偏好、可验证奖励 | RLCD:校准过的概率决策 |
| 输出 | 字符串,需解析 + 校验,可能跑偏 | 类型化输出:选项预先定义,不可能出现类型错误 |
| 采样方式 | 顺序解码:一次一个 token,每个依赖上一个 | 并行:一次查询算出全部答案 |
| 成本 | 输入 $0.20–$10 / 百万 token;输出约为输入 5 倍 | 输入 $0.042 / 百万 token;输出按官方定价免费 |
| 速度 | 端到端 3–329 秒(官方引用外部 benchmark 的口径) | 端到端 70–500 毫秒 |
| 置信度 | 即使被要求给置信度,也普遍过度自信、前后不一致 | 每个答案都带校准过的置信度 |
注:以上为官方口径;「3–329 秒」是官方引用的外部测试页面对前沿模型的统计区间,不是所有 LLM 在所有任务上的普遍表现。
全部能力就三种问题
- Noul(是 / 否):返回 P(true),例如「这封邮件表达了紧迫性吗」→
0.999。 - Choice(选哪个):返回选中项、全分布与置信度,例如「工单该给哪个团队」→
billing 0.84 / technical 0.159 / sales 0.001。 - Score(程度多高):返回一个分数、对应的尺度说明(legend)和置信信息,例如「客户有多愤怒」→
1.035。
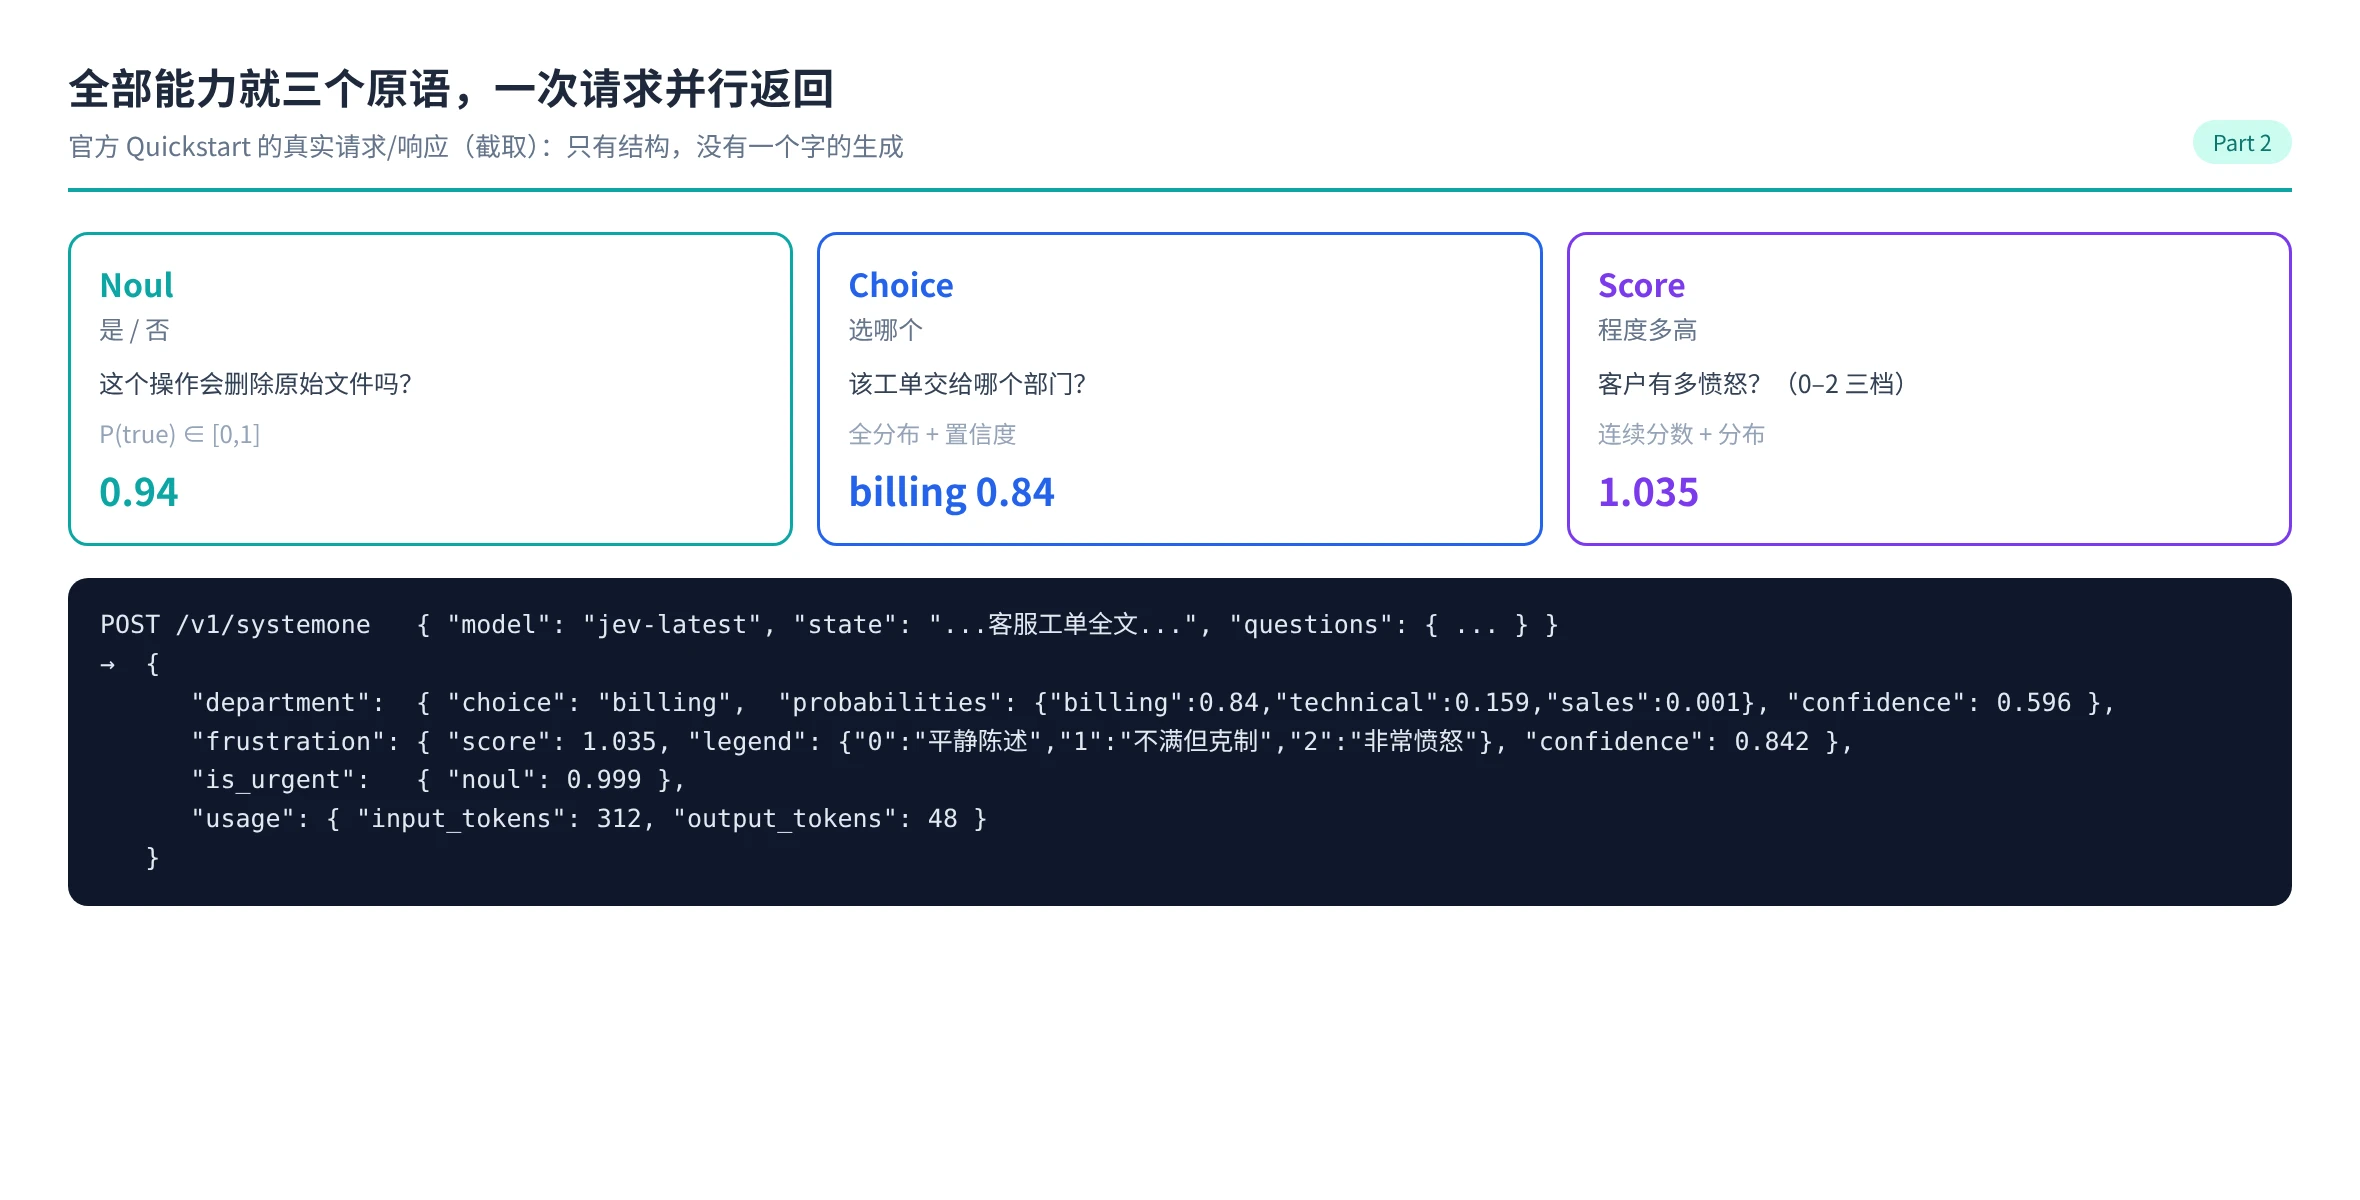
图 3:三种原语,以及官方 Quickstart 中一次请求并行返回的真实结构。
几个决定成败的文档级细节(逐条核对过官方文档)
- 问题 ID 不会发给模型。ID 只是给你代码用的 key,模型只看
instructions,所以 instructions 必须自包含。 - 一次请求里塞满问题是官方推荐的用法:把所有分支可能用到的问题一次发出,代码事后决定用哪个。官方说法是「增加问题通常不会增加延迟」;限定条件是请求规模与输入长度可控,且输入 token 消耗确实会增加。
- 官方明说校准是群体口径:「Calibration is measured across groups of predictions; it does not guarantee that an individual answer is correct.」这句话比任何宣传词都重要:阈值必须在你自己的数据上调。
- 目前只吃文本:字符串、JSON、文本数组都行,图像 / 音频 / 视频不支持(官方原文为 not supported yet)。
- 调用极简:
POST /v1/systemone,模型别名jev-latest时解析到jev-1.13.0,2026-09-18)。
03|Jev 为什么快:它砍掉了自回归
LLM 慢不是因为笨,而是因为输出阶段必须逐步解码:每多一个 token,就多一个依赖前文的解码位置。哪怕你只要一个「是」或「否」,它也得先把 {"answer": " 这串字符生成出来。Jev 的做法是不做自回归,所有问题一次前向算完,直接读概率头,于是:
- 输出只有一个决策、少到不值得计量,官方直接按免费定价(API 返回中仍会记录
output_tokens字段,这是计费免费,不是不存在输出 token); - 延迟方差小:官方称 70–500 毫秒,而 LLM 的 3–329 秒是一个跨越两个数量级的区间——对工程系统来说,可预测性比绝对值更重要;
- 官方 side-by-side Demo 的对照是 Jev 0.114 秒 / $0.000081,对 GPT-5.6 Terra 的 8.566 秒 / $0.013880 [官方自报]。
官方价格结构(,来源为官网首页与发布公告):输入 $0.042 / 百万 token,即 $42 / 十亿 token,输出按官方定价免费;官网另称输入价比 Claude Fable 5.1 低 238 倍。价格属于会变动的商业信息,接入前请以控制台实际计费页为准。
头条数字的边界必须写清楚:193.6× 更快、444.6× 更便宜 来自 TypeSafe 自己设计的 4 条工作流评测,参考答案是 GPT-6 Astra 与 Claude Fable 5.1 高推理模式输出的平均;官方博客自己列了三条偏差说明——工作流由自家能力团队设计、参考答案偏向 OpenAI / Anthropic、被测 LLM 使用的是官方提供的结构化输出 wrapper。也就是说:同一套工作流、官方出题、官方选裁判。这份自我披露值得肯定,但它不是独立基准。
04|Zero Hallucinations 到底是什么意思
官网上最醒目的一句是 Zero Hallucinations,配图给出的工具调用类型错误率是 0%。
这句话的准确含义是:模型的输出分布永远定义在你给的 criteria 上,因此它不可能编造字段、编造选项、编造 JSON——这是结构与类型层面的保证。
它不包含:判断本身正确。Jev 完全可以在你给的选项里高置信度地选错。
Hacker News 上这条反驳最典型([社区观点],用户 jacobgold):
"Also 'can't hallucinate' seems wrong? Sure, it can't emit an invalid type, but it can still emit a completely wrong valid value… You can enforce structured output from an LLM too, with an appropriate harness."
另一位(resonious)说得更短:
"maybe we should stop saying 'can't hallucinate' when it can by definition."
创始人在 Hacker News 评论区正面回应过这个争论(ID:CompleteSkeptic)。当有人指出「用约束解码就能让 LLM 做同样的事」时,他的回答是:constrained decoding(OpenAI 式的结构化输出)会让模型变笨——因为如果一个模型会给非法 token 分配概率,它本身就是糊涂的。这个回应技术上有其道理(结构化输出确实会损失 LLM 能力),同时也意味着:Jev 的价值不在「不会错」,而在结构天生存在、不需要拿模型能力去换。
而官方文档那句最诚实的话再次适用:校准是跨预测群体衡量的,不保证单个答案正确。 如果模型确实在与你的业务分布相近的数据上完成了校准,那么一组被标为约 90% 置信度的预测,长期平均正确率可以接近九成;这不代表你手上这一条有九成把握。
05|数据核对:官方自报 vs 第三方实测
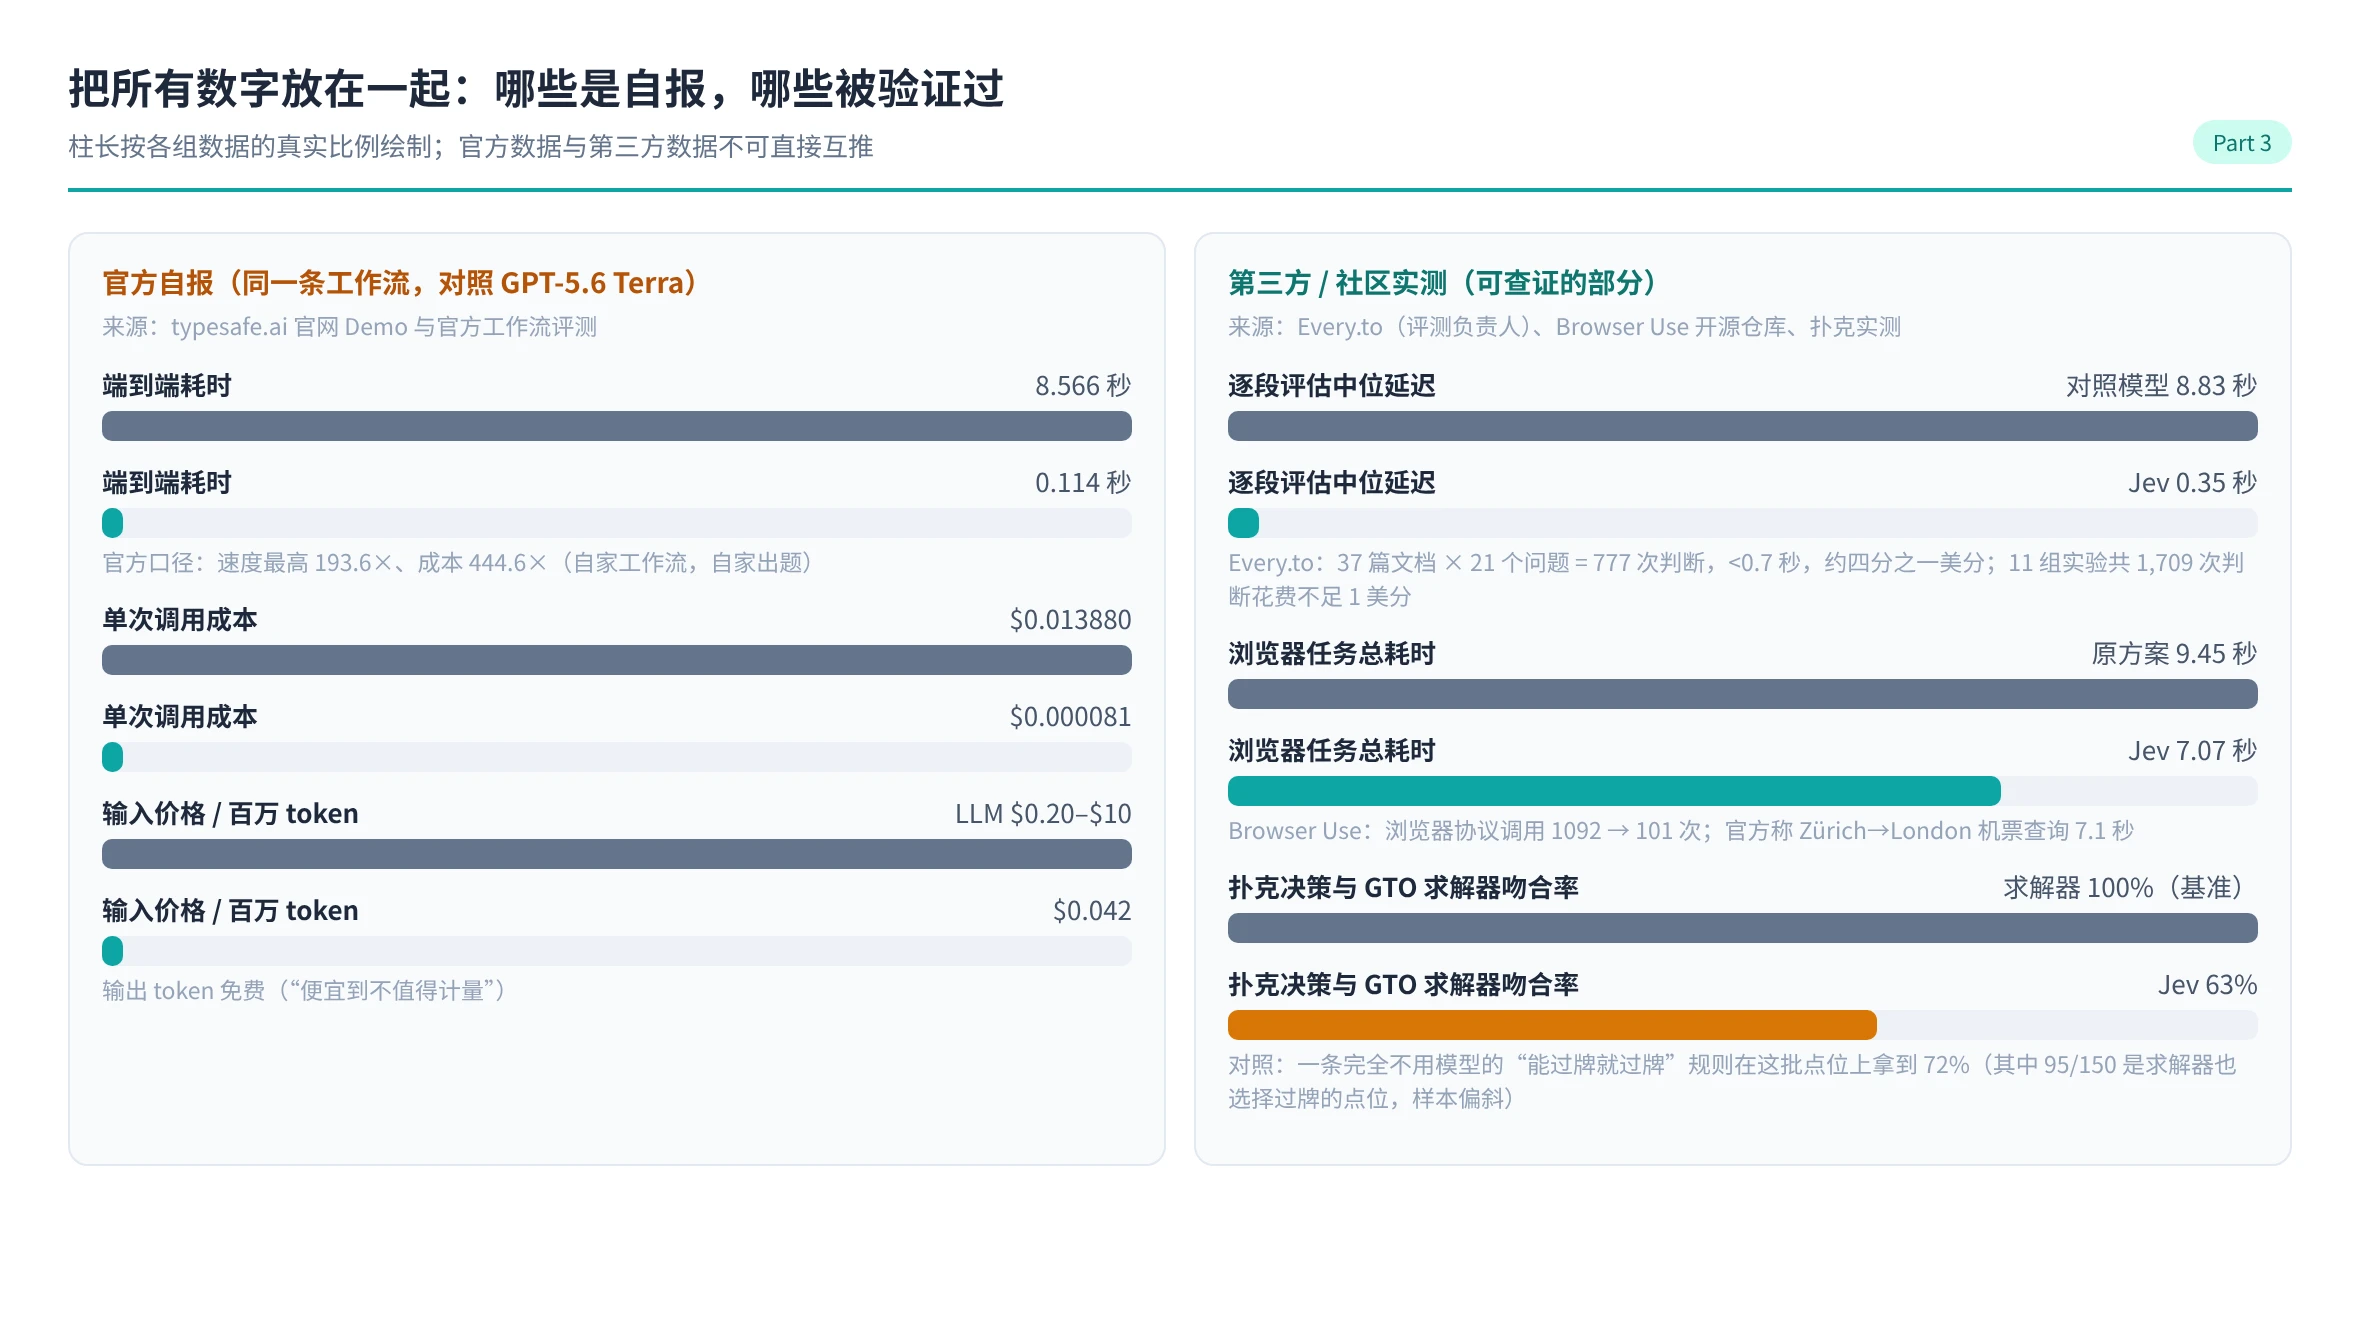
图 4:柱长按各组数据真实比例绘制。左列全部为官方自报,右列为可查证的第三方 / 社区实测。
表 A:官方自报
| 指标 | 数值 | 备注 |
|---|---|---|
| 端到端延迟 | 70–500 ms | 官方对照 LLM 为 3–329 s |
| 头条倍数 | 193.6× 更快 / 444.6× 更便宜 | 自家 4 条工作流评测中的最大差距 |
| 工作流准确率 | 约 67.8% | 官方给出的前沿模型区间约 68%–74%,即水平接近而非超越 |
| 单 case 成本 | 约 $0.0004 | 官方口径响应时间约 0.4 s |
| 类型错误率 | 0%(工具调用 0%) | 与「不会判断错」是两件事 |
| 输入价格 | $0.042 / 百万 token | 截至 2026-09-19;输出按官方定价免费 |
表 B:第三方与社区实测
| 测试者 | 方法与样本 | 结果 |
|---|---|---|
| Every.to(Mike Taylor,该站评测负责人) | 37 篇文档 × 21 个问题同时提问;单组 777 次判断;作者称共跑了 11 组实验 | 单组 777 次判断 <0.7 秒,估算成本约四分之一美分;逐段评估中位 0.35 s,对照模型 8.83 s;故意植入的 7 处缺陷检出 6 处(漏 1 处)。作者结论:快与便宜站得住,准确率「够用但不完美」 |
Browser Use jev-ultrafast(MIT 开源) |
同任务交替运行 6 次,比较新旧 harness;仓库 star 数约 5.7k(2026-09-19) | 通过率均 3/3;中位耗时 9.45 s → 7.07 s(约 −25%,即速度约 1.34 倍);浏览器协议调用 1092 → 101 次;Google Flights 苏黎世→伦敦一次搜索 7.073 秒(含加载等待与文本生成) |
| Vercel(工程师 Pranit Sharma,原帖,经 TechCrunch 转述) | 把命令安全分类从 GPT-5.6 Luna 换成 Jev | 快 5–18 倍,且更准——[待补证]:未见完整测试报告,按转述看待 |
| Bryo AI(CTO Nikhil Mudholkar,原帖) | 业务邮件分类,对比 Gemini | Gemini 略更准,但贵 10–20 倍;他更看重 Jev 返回的真实概率——个人自述,非系统评测 |
| backnotprop | 用德州扑克 GTO 求解器当答案,150 个决策点 | 与求解器首选动作吻合率 63%;详见下一节 |
需要更正的旧说法:第三方实测并没有复现「快 25 倍」这类数字。目前可查证的量级是:成本极低(单组测试不足一美分)+ 部分场景耗时下降约 25%;通用任务上的 193.6 倍速度优势,尚无独立复现。
06|独立扑克实测:与 GTO 求解器的差距
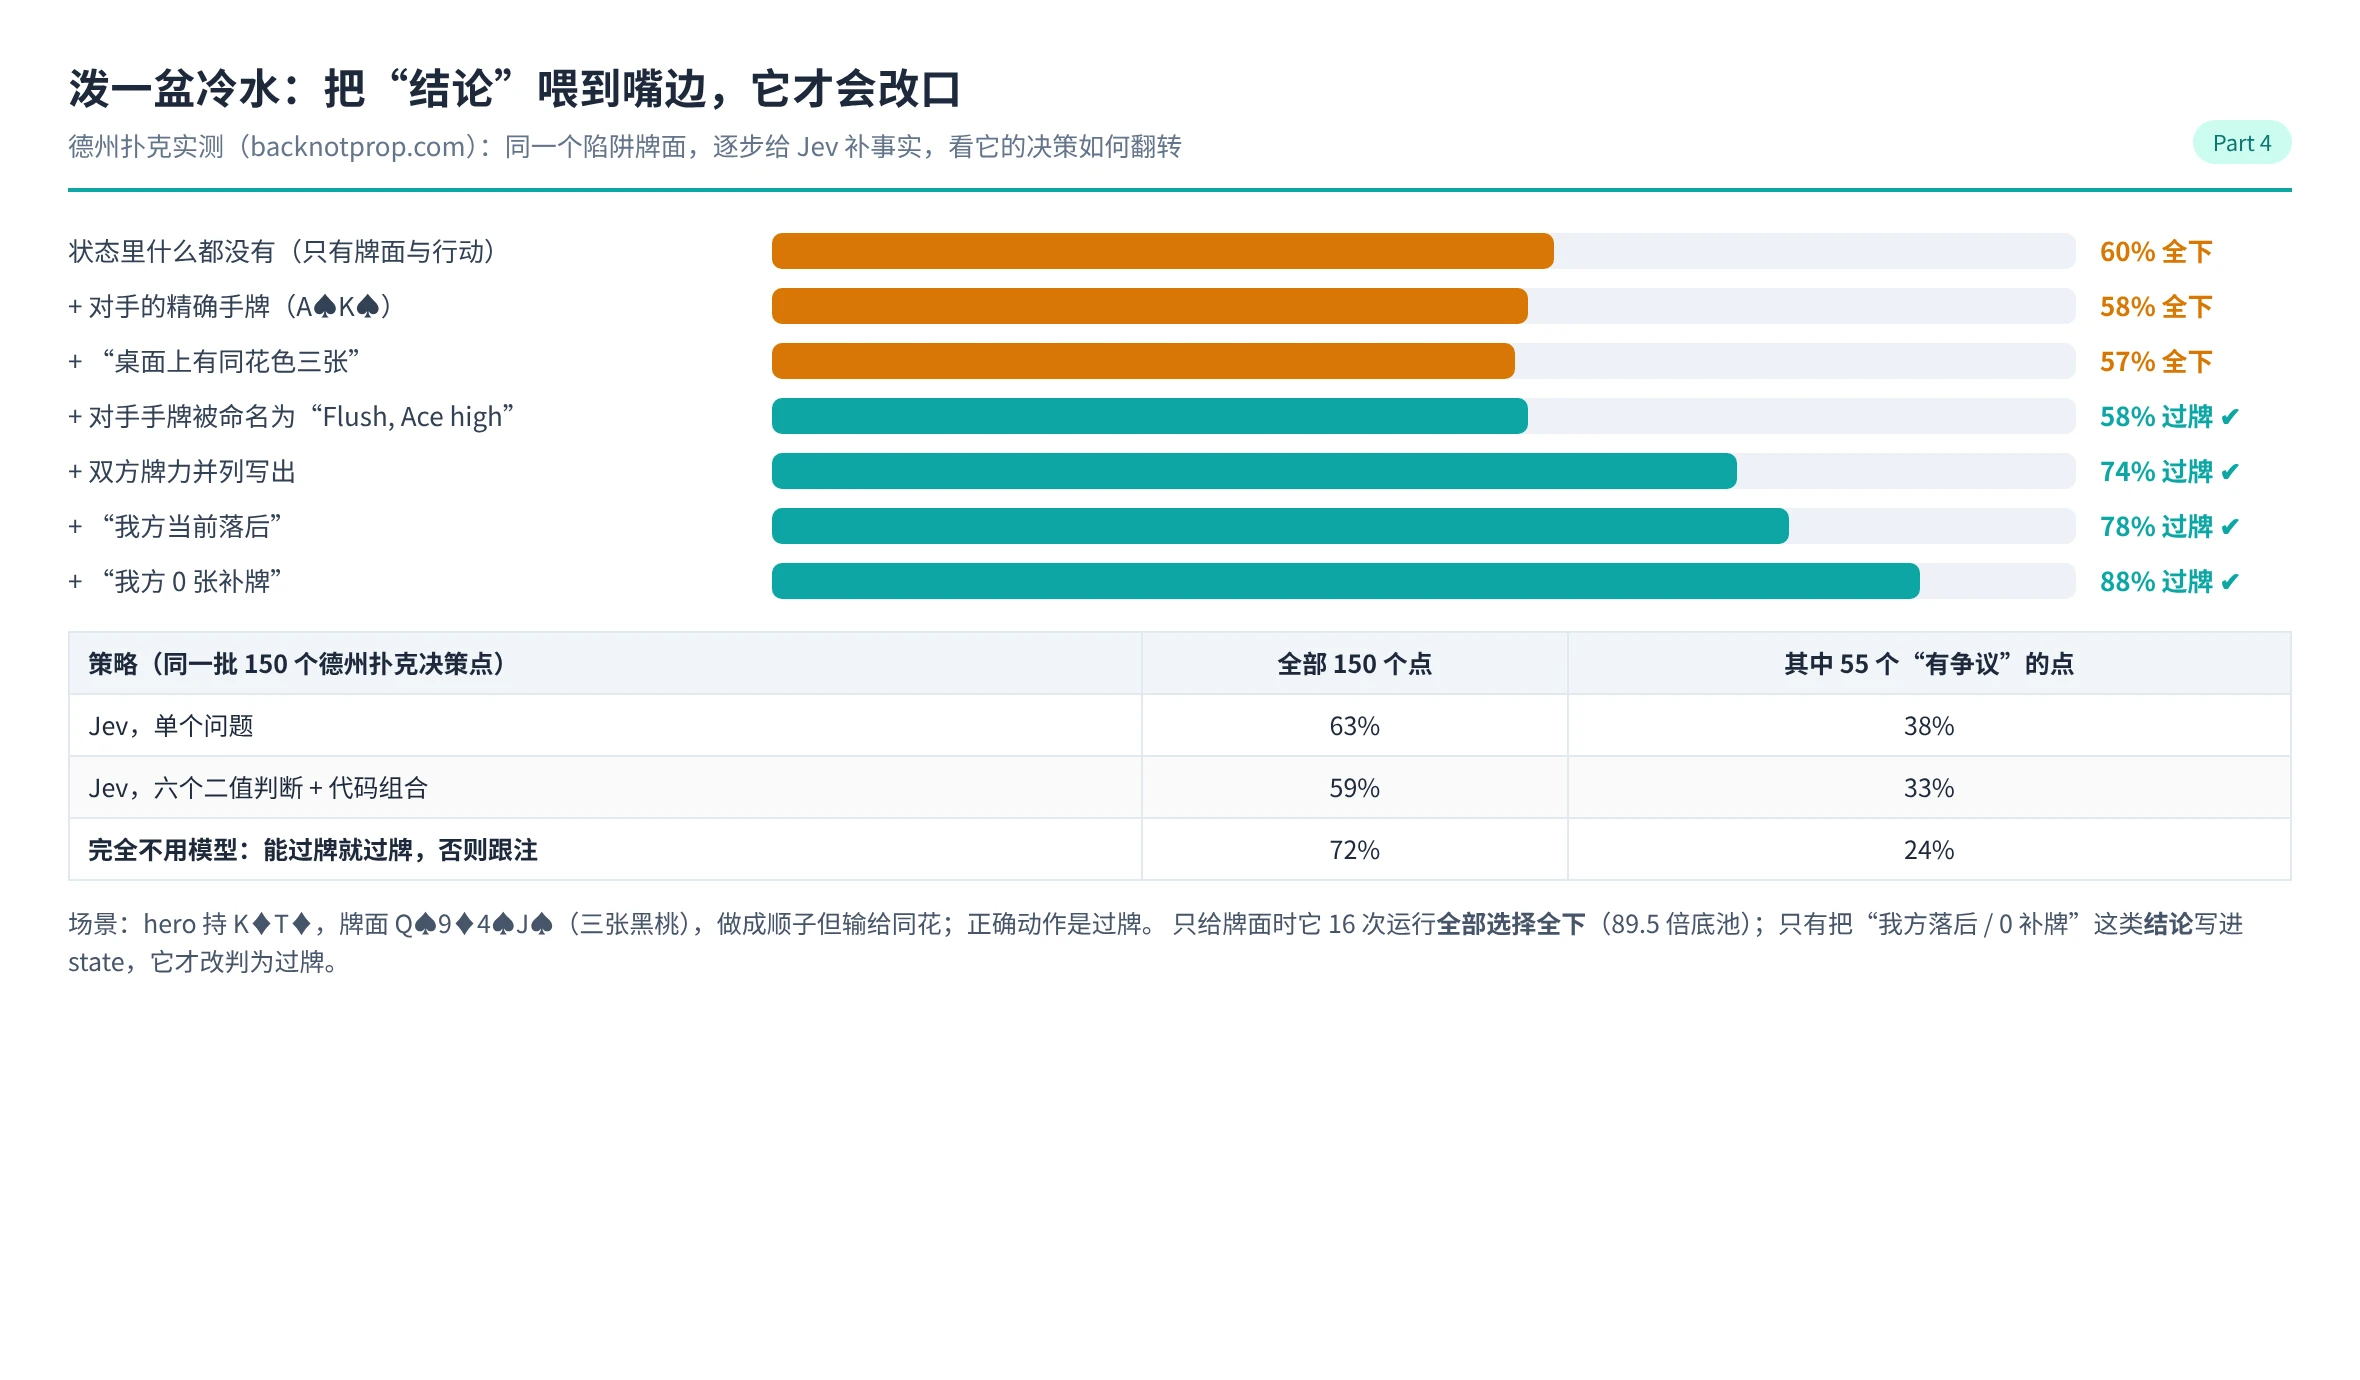
图 5:同一个牌面逐步补事实,Jev 的决策如何翻转(数据来自 backnotprop.com 的实测)。
这是目前公开资料里扎得最深的独立测评:作者先用 TexasSolver 解了一个翻牌面(8 分钟、7.6 GB、0.59% 可被剥削度)作为标准答案,再把牌桌状态构造成 state 交给 Jev,问它该从求解器给出的合法动作里选哪一个。两个相邻牌面要分开看:
- 牌面 Q♠ 9♦ 4♠ J♥(无同花可能):hero 持 K♦T♦,做成 K 高顺子,是当前最好牌;正确动作是过牌(在 22.5 的底池推 89.5,只会被更好的牌跟注),Jev 16 次运行、16 次全部选择全下。
- 把 turn 换成 J♠(三张黑桃):顺子已经输给任何同花,Jev 依然以约 60% 的概率选择全下;即便把对手的精确手牌(A♠K♠ 这类成大同花)写进 state,决策也没有改变。
它需要你把结论喂到嘴边:state 里补上「对手手牌 = Flush, Ace high」「我方当前落后」「我方 0 张补牌」这类已经得出结论的字段之后,它才改判为过牌。
作者的对照实验同样重要,且必须连同样本偏斜一起读:在 150 个决策点里,求解器有 95 个点自己也选择过牌,因此一条不用模型、永远「能过牌就过牌,否则跟注」的一行规则在全部点位上拿到 72%——这个数字大部分来自样本偏斜;但在真正有争议的 55 个点上,该规则只有 24%,而 Jev 单一问题形态为 38%,六个二值判断加代码组合为 33%–44%(原始数据表)。作者结论:Jev 确实在做事情,但在这些点位上它错得比它对得多;上线前必须为每个具体场景单独评估,并算清错一次的代价。
其他冷水
- [社区观点] Hacker News 用户反馈它在单步迷宫这类空间推理任务上不稳,推测训练分布缺少此类任务;本次未做独立复现。
- [作者判断] Sean Goedecke 的分析被广泛转发,核心三点:① 快的结构化输出现在就能做——约束解码 + 只生成一个受限 token + 预填充,他自己用 Qwen2.5-1.5B 得到 2–3 倍加速,因此他推测 Jev 未必有技术护城河;② 它没有思维链、没有测试时计算,智能上限可能被锁在「非推理 LLM」水平,不要指望它 scaling 出新智能;③ 「零幻觉」是语义上的回避。
- [社区观点] r/LocalLLaMA 的「这不就是 BERT 吗」之争里,几条有信息量的回答:它「就是 BERT 式架构,只是配上了现代 LLM 的数据、算力和训练配方」(u/RobbinDeBank);「最接近的老东西是 NLI 零样本分类,区别在于 NLI 每个标签跑一次前向、分数不可比,而 Jev 一次并行给全分布」(u/Open-Adhesiveness-86);「单拎出来没有革命性,但它把够聪明、够便宜、够快、够方便凑齐了,这是以前做不到的」(u/sjoti)。
07|该不该用:Agent 决策栈里的位置与三条军规
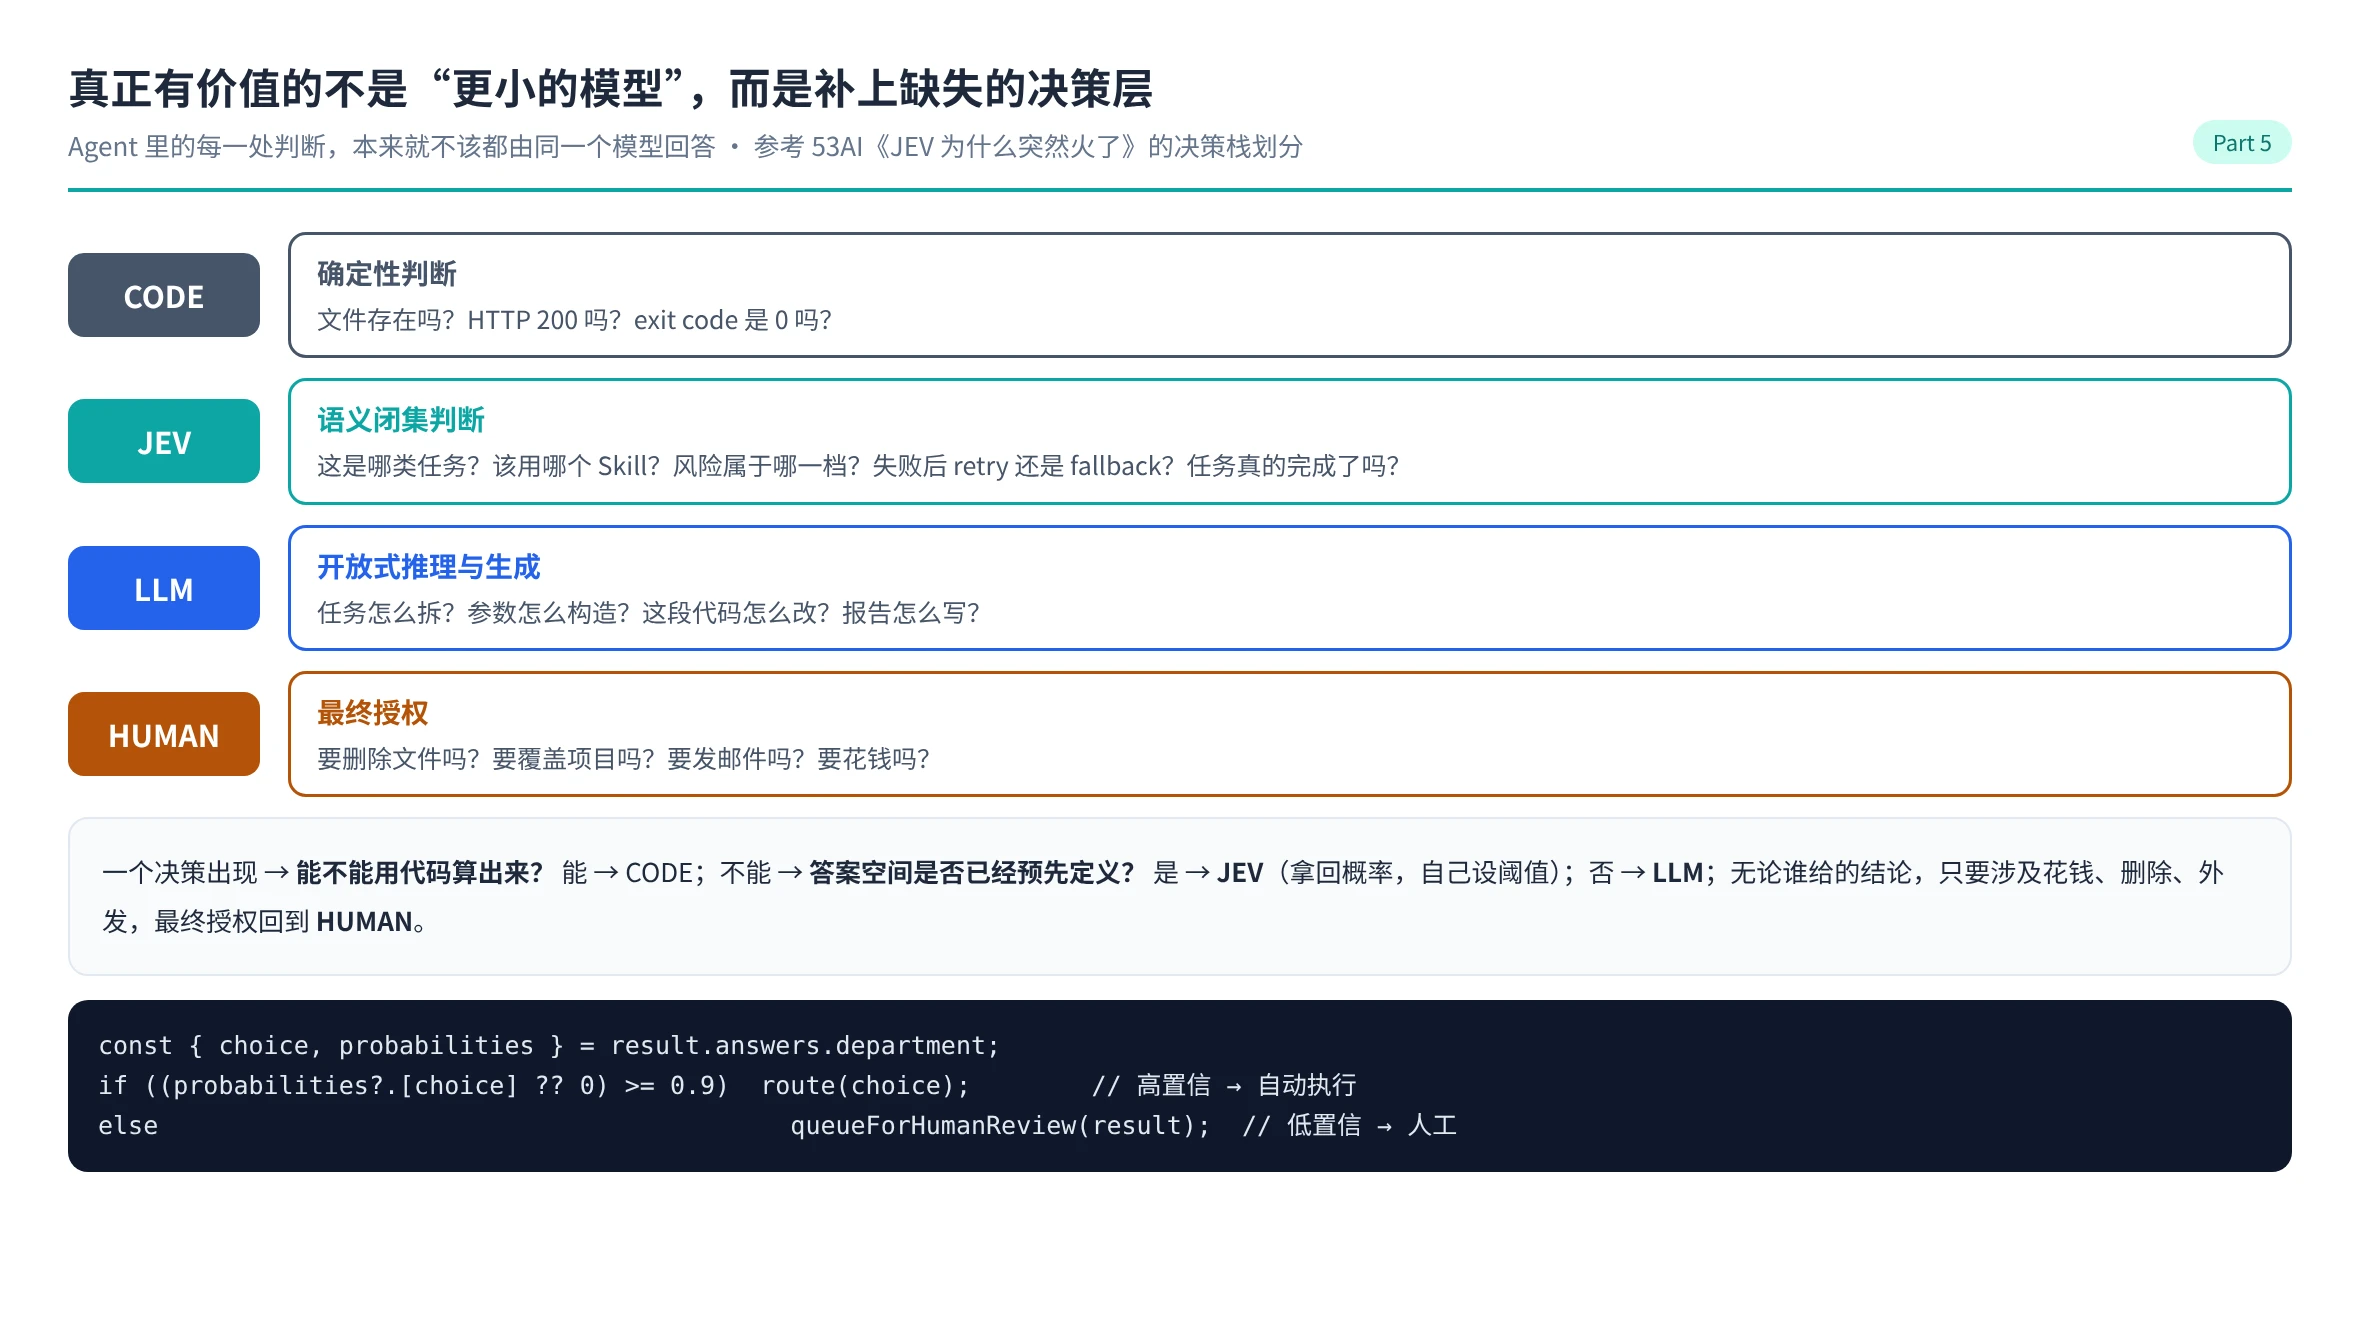
图 6:把 Agent 里的判断按「能不能算出来 / 答案空间是否预定义」分工(分层思路来自 53AI 的架构分析,此处重绘)。
理解 Jev 最有价值的地方,是知道它占的是哪一格:
| 层 | 负责的判断 | 例子 |
|---|---|---|
| Code | 确定性判断 | 文件存在吗?HTTP 200 吗?exit code 是 0 吗? |
| Jev | 语义闭集判断 | 这是哪类任务?该调哪个 Skill?风险属于哪一档?失败后 retry 还是 fallback?任务真的完成了吗? |
| LLM | 开放式推理与生成 | 任务怎么拆?参数怎么构造?这段代码怎么改?报告怎么写? |
| Human | 最终授权 | 删除文件、覆盖项目、发送邮件、花钱 |
适合:意图分类与模型路由、难度估算、护栏与安全判断、敏感信息与越狱检测、LLM 输出的验证与打分、RAG 结果的排序过滤、高频实时决策(游戏 AI、浏览器 Agent 的每一步动作)、大语料 map-reduce(把整张表扫成「语义列」)。
不适合:需要生成文字、需要推理链、需要从原始信息推导出隐含结论的场景——扑克实测就是最好的反例:它不「算牌」,它只「读你写好的结论」。同样不适合没有标注数据、没校准过置信度就全自动执行的场景。
08|生态:发布 72 小时里长出来的东西
一个闭源模型发布三天,周边长出这些,本身就是信号:
- Browser Use
jev-ultrafast(MIT):把浏览器动作空间做成「操作 + 目标」两组 Choice,一次网络往返出两个决策,默认循环里不截图。官方另附原始测量:DONE之后仍需独立的结果校验;shadow DOM、iframe、canvas 等不在 MVP 范围内。 - LangChain 集成:
TypeSafeClassifier直接.invoke(state, questions);更值得注意的是ModelRouterMiddleware(用 Jev 决定这次请求交给便宜模型还是强模型)与AutoModeMiddleware(执行前判断工具调用是否有风险)——这恰好是 Jev 最稳的两种用法。 - Vercel AI SDK:新增实验性
experimental_evaluate,Jev 是第一个原生实现;接口抽象已经把「帮我写」(generateText)和「帮我判」(evaluate)分开。 - 社区复现潮:
jevlike(逆向复现同形架构)、open-jev(Gemma 3 4B)、Mini-Jev、作品集站madewithjev.com。 - 野生的用法 [社区观点]:Doom(每秒约 10 次决策,官方称成本约 $7/小时)、宝可梦对战、Claude Code 的上下文压缩插件(把「这条工具调用还有用吗」变成并行 Noul 问题,保留内容为原文)、模型路由、邮件分流。
09|结论
Jev 的方向值得关注,但目前更适合被理解为一种面向软件决策的专用模型,而不是通用 LLM 的替代品。官方数据清楚展示了它在延迟、成本与类型约束上的优势;独立测试也支持「快、便宜」这一判断,但尚不足以证明它在所有语义任务上都能达到前沿模型水平。
对开发者而言,合理的接入方式是先把 Jev 放在分类、路由、护栏、验证、排序这类边缘决策位置,再用自己的业务样本测准确率、校准情况与错误代价。有三点必须记住:
- 类型安全不等于事实正确——它只是不会编出选项之外的答案;
- 置信度不等于单条预测必然正确——官方文档自己写明校准是群体口径;
- 它不会推理——扑克实测里,它需要你把结论喂到嘴边才改判。
其他已知限制:目前只支持文本输入,图像 / 音频 / 视频不支持;架构未公开,「RLCD 是不是新范式」目前无法判断;官方不发布标准基准,目前不能仅凭公开榜单判断它是否适合你的业务。此外,本文没有做中英文对比测试——中文拆解文称官方文档提到中日韩文本「可接受但准确率更低」,但本次核查未在官方文档中找到该表述,因此不作为事实引用,中文场景请自行验证。
至于它是否值得现在押注:把它放在 Agent 的每个决策点上试水是划算的;把它当成能替代 LLM 推理的核心链路,则还没有证据支持。
参考资料
一手官方
- 发布公告《Introducing System One Models & Jev》— https://typesafe.ai/blog/introducing-system-one-models-and-jev (2026-09-15)
- 《The Bitterest Lesson》— https://typesafe.ai/blog/bitterest-lesson (2026-09-10)
- 《Lies, Damned Lies, and Benchmarks》— https://typesafe.ai/blog/antibenchmaxxing (2026-09-11)
- 官方文档:System One 概念 / Quickstart / 三种原语 / Speculative fan-out — https://docs.typesafe.ai/concepts/system-one ・ https://docs.typesafe.ai/introduction/quickstart ・ https://docs.typesafe.ai/primitives/choice ・ https://docs.typesafe.ai/patterns/fan-out
- 官网首页(193.6× / 444.6×、$42/十亿 token、238× 与 Demo 数字)— https://typesafe.ai/
- 官方团队页 — https://typesafe.ai/team
- 投资方 DCVC 的投资公告 — https://www.dcvc.com/news-insights/typesafe-emerges-from-stealth-with-a-new-way-of-doing-ai/
媒体(含转述内容,引用时按转述看待)
- Forbes《This $200 Million Startup Wants To Fix AI's Overconfidence Problem》— 2026-09-15 — https://www.forbes.com/sites/the-prompt/2026/09/15/this-200-million-startup-wants-to-fix-ais-overconfidence-problem/ ($4000 万种子轮与 2 亿美元估值的原始出处,估值信源为匿名知情人士)
- SiliconANGLE《TypeSafe AI exits stealth with $40M to build AI for use by software》— 2026-09-16 — https://siliconangle.com/2026/09/16/typesafe-ai-exits-stealth-with-40m-to-build-ai-for-use-by-software/
- TechCrunch《A new kind of AI model from a ChatGPT inventor is thrilling developers》— 2026-09-18 — https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/
- The Register《TypeSafe AI debuts model for machines that plays Doom》— 2026-09-16 — https://www.theregister.com/ai-and-ml/2026/09/16/typesafe-ai-debuts-model-for-machines-that-plays-doom/5296711
- 36 氪 / 腾讯科技《一个"不说话"的 AI 刷屏,Jev 真是新范式吗?》— 2026-09-18 — https://eu.36kr.com/zh/p/3988164509711361 (估值与 X 浏览量的转述来源)
- 钜亨网《速度快 200 倍、成本降 400 倍!前 OpenAI 研究员闭关两年推出 LLM 新模型 Jev》— 2026-09-17 — https://news.cnyes.com/news/id/6608577
- 赢政天下《ChatGPT 联合发明人推出 Jev》— 2026-09-17 — https://www.winzheng.com/article/jev-ai-decision-model-typesafe-diogo-almeida-system-one (Every.to 中位延迟与 1,709 次判断数据的转述来源)
独立测评与社区
- Hacker News 主贴(1893 分 / 496 评论 2026-09-19)— https://news.ycombinator.com/item?id=49717558
- Every.to《Mini-Vibe Check: TypeSafe's Jev Judged Everything I've Written in 0.7 Seconds》— 2026-09-15 — https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-seconds
- backnotprop《Jev is the 🐠 at the poker table》— https://backnotprop.com/blog/jev-poker/
- Sean Goedecke《Jev means structured output is interesting again》— https://www.seangoedecke.com/jev-means-structured-output-is-interesting-again/
- r/LocalLLaMA《still doesn't get what Jev is…..is it just a more generalised BERT?》— https://www.reddit.com/r/LocalLLaMA/comments/1wje4xh/
- Browser Use
jev-ultrafast(含 performance.md 原始测量)— https://github.com/browser-use/jev-ultrafast - LangChain《Building a Harness with Jev》— 2026-09-17 — https://www.langchain.com/blog/building-a-harness-with-jev
- 掘金《发布 3 天登顶 HN:不生成一个字的模型 Jev,我把它的源码和黑料都扒了一遍》— 2026-09-18 — https://juejin.cn/post/7686669083098775562
- 53AI《JEV 为什么突然火了?因为 Agent 里缺的可能不是模型,而是"决策层"》— 2026-09-18 — https://www.53ai.com/news/LargeLanguageModel/2026091829863.html
本文为资料整合与二次核对,非一手实测;所有引用数字均标注了来源与性质,欢迎按上表逐条复核。